我发现了渗透Agent长程任务的秘密
由斗象科技旗下漏洞盒子平台发起的“赛博司机计划”,举办了“蛙池 AI Desktop 100小时不间断Agent渗透测试挑战”,搭载长程任务专用Sonic Harness,在高难度渗透评测靶场VulnHouse上持续作业。我们之前已经发过一篇战报,分析了它的最终成绩。
具体文章内容可以点击链接查看→《100小时长征:史上首个Agent自主不间断渗透完整战报》
评论区讨论度最高的问题并不是Sonic Harness打穿了多少道题,而是另一个更底层的疑问:它是怎么撑住超长进程任务的?毕竟大多数单会话 Agent跑几十轮tool call就开始出现注意力衰减和事实误判。
我们把 Sonic Harness的技术报告从头到尾扒了一遍,发现它能撑住 100 小时,靠的不是让模型更聪明,而是从工程上确保模型无法绕过校验流程。
01 长程任务,单会话Agent的三重天花板
技术报告中指出,把整条 kill-chain 交给单会话 Agent ,会撞上三重天花板:
第一个是上下文膨胀。一个会话跑几十轮 tool call 之后,模型的注意力会衰减,早期侦察到的关键证据会被后续输出冲淡。
除了注意力稀释,成本也是硬约束,每跑一轮任务都要把全部历史重新送入模型,上下文越长,单次推理的token消耗越高。到任务中后期,光维持上下文的开销,可能已经超过实际执行任务的成本。
第二个是幻觉自证,也是长程任务中危害最大的一个。Agent在自己的推理链里“追认”起一个从未真正发生过的观测,然后把它当成后续决策的前提。由于缺乏外部独立视角的校验,这种幻觉会在单会话推理中不断自我强化,模型会始终在自身的推理链内部确认这个从未发生过的事实。
第三个是中断即回零。单会话Agent将所有中间状态保存在内存会话对象中,一旦进程终止,全部状态即刻丢失,无从续跑。
这三重问题叠加,解释了为什么大多数 Agent 演示只能维持较短的运行时间,问题不在于模型能力不足,而在于单会话架构本身无法支撑长程任务的持续运行。
Sonic Harness的设计选择很明确:把LLM层面的“我完成了”降级为提议,把“是否完成”的判据下沉到harness强制的双准入判据与内容签名的工作区完整性栅栏。
02 MEA三角循环:一个角色拆成三个,互相独立复核
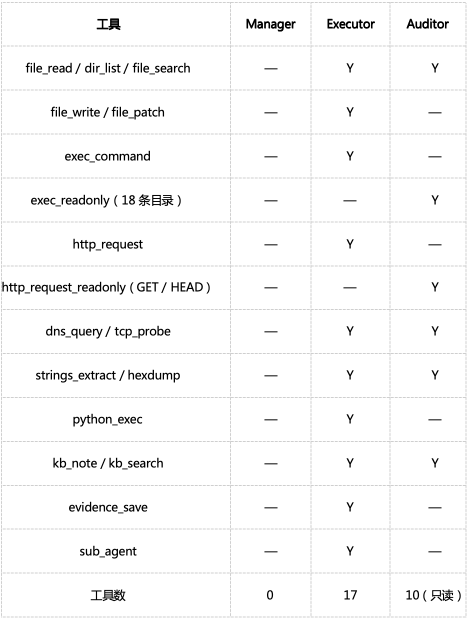
Sonic Harness的核心是一个由harness强制的 MEA (Manager/ Executor/Auditor)三段式循环审计,三者之间在工具集、上下文、会话 ID 三个维度上完全物理隔离,共享的只有 harness 渲染出来的结构化文本和证据仓的哈希引用。
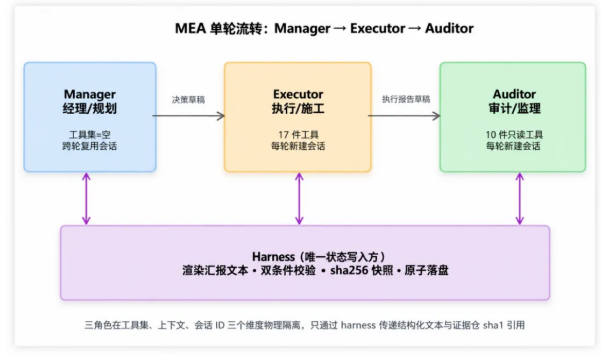
Manager相当于项目经理, 它在整个任务生命周期里只持有一个会话,负责跨轮规划、拆任务、决定下一步目标。但它的工具集硬编码为空(tools=∅),看不到文件系统,看不到执行环境,也碰不了网络,只能根据harness渲染的确定性文本做决策。
报告里指出这样设计的理由是“信息面统一”,Manager 从不接受 Executor 单方面沉淀的事实,只信 harness 认可、Auditor 复核过的记录。
Executor是施工队,每一轮都新建一个会话,挂载17件通用工具,覆盖渗透测试需要的所有通用操作,但只对本轮合约负责,轮末直接抛弃,不留记忆、不跨轮积累。
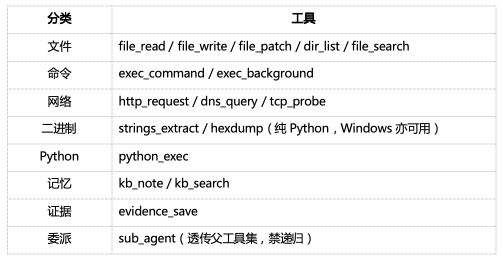
Auditor则是监理,每轮同样新建会话,但只挂载10件只读工具,不包含任何写入类工具,也不具备 Python 执行和后台进程能力。
三个角色的工具集大小呈现 0 <10 < 17 的严格递增关系,构成一条 harness 可静态验证的工具面积单调链,从代码层面直接锁死,Manager 想越权拿工具,构造函数里就过不去。
MEA三角分工解决了“谁来做、谁复核”的问题,但还有一个更底层的隐患:如果Manager一意孤行,在证据不足时宣布完成怎么办?如果Auditor自己填了clean,但工作区其实已经被改过,又该怎么办?物理隔离只能防止三方串通,不能防止单方自证。
03 执行框架的四道关键设计:既防自欺,也防崩溃
这部分也是Sonic Harness最硬核的设计,它在harness侧设置了强制执行的信任边界,核心原则就是:LLM说的话不作数,harness观察到的才作数。
设计一:ZTNA零信任叙述审计——独立复核,不信转述
Executor 执行完成后,会在报告中声明 “已完成 XX,证据在 XX”。常规Agent 系统里,这一声明即为定论,模型自述的结果会被直接采纳。
Sonic Harness的处理方式,是将Auditor 的复核流程分为两个阶段:
阶段一,挂载工具复核。Auditor使用持有的10 件只读工具,对 Executor 声称完成的每一项任务、发现的每一个事实,逐条独立复现或反驳。
例如 Executor 声明 flag 已写入 /tmp/flag.txt,Auditor 需自行执行 cat 和 sha256sum,确认文件确实存在且内容一致。这一阶段仅输出自然语言的复核笔记,不产生正式裁决。
阶段二,撤离工具,出具裁决。此阶段 harness 收回 Auditor 的全部工具集,Auditor 仅基于阶段一的查证结果,填写正式审计报告,每项任务给出三选一裁决:verified(独立复现通过)、unverified(证据不足但无反证)、refuted(观察到与声称相悖的事实)。
为什么第二阶段要撤离工具?报告里给出的理由有两个:一是避免 Auditor 在填写裁决时再次调用工具,导致复核与裁决两个阶段混淆,二是确立“结论必须由证据支撑”的纪律。如果 Auditor 在出裁决时还能调工具,它可能会在裁决阶段“补做”复核,导致裁决依据的不是阶段一已经固化的证据,而是裁决时临时看到的新观察,这会让“审计”变成“再执行”。
此外,Executor 输出的 narrative不纳入证据范畴。Auditor 仅采信两类信息:从环境中直接读取的内容,以及通过只读工具独立获得的观察。无论 Executor 对执行过程的描述多么详尽,Auditor 均不据此下判断。
设计二:完成态铁律——双准入判据
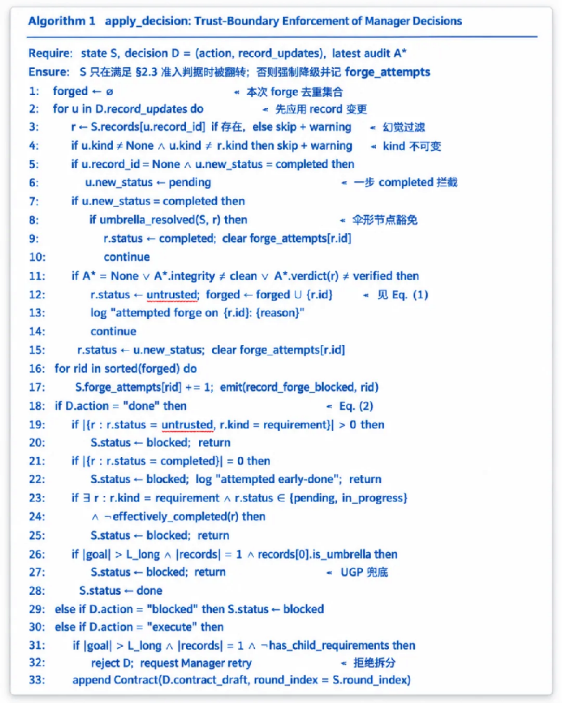
Manager基于Auditor报告,判定某条任务可以完成时,会输出决策:将该记录标记为 completed。
harness 在写入状态之前,会做一次双条件校验:
- 1. 最新审计报告里,这条记录的裁决必须是 verified;
- 2. 同一时刻,工作区完整性状态必须是 clean。
两个条件同时满足时,才允许把状态翻转为 completed。任一条件不满足,harness 都会强制把这条记录降为 untrusted,并且记一次伪造尝试(forge_attempts)。
这里需要强调的是,降级是harness强制执行的,而不是对Manager的提示性建议。
Manager 的提议仅为草稿,状态的最终写入权完全归属harness。即使Manager连续试图将未完成的记录标记为完成状态,也每一轮都会被拦截。
不是依赖 prompt 层面的诚实性约束,而是在代码层面确保任何未经校验的完成提议都无法生效的物理级信任隔离。
Manager的决策动作也仅有三个选项:execute(继续执行)、done(结束任务)、blocked(报告受阻原因)。系统中不存在 “求助” 动作,遇到卡点时,Manager 必须在 blocked_reason 中说明具体原因,由 harness 记录后退出任务。
设计三:CSWI完整性栅栏——事后兜底的哈希校验
工具级过滤是第一道防线,但也并非万无一失,如果后续SDK新增工具时没有从Auditor集合中剔除,或者模型通过未预料的内部通路执行了操作,CSWI(内容签名的工作区完整性栅栏)就是Sonic Harness设置的进行事后核查的兜底机制。
具体做法是在审计阶段开始前和结束后,各采集一次工作区目录的 sha256 哈希清单。小文件计算完整哈希,超过阈值的大文件退回,改用文件大小和修改时间进行近似校验。如果审计前后两次快照对比,发现有文件发生变更,无论是新增、修改还是删除,harness 直接将完整性状态覆盖为 violated。
核心原则是Auditor 在报告中自填的“完整性 clean”不具有最终效力。如果harness自己观察到diff非空,就强制覆盖为violated,日志记录固定为“Auditor自称clean但CSWI观察到diff,以harness观察为准”。
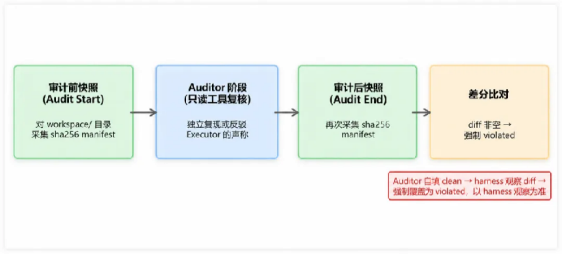
这就相当于在工具级“门禁”之外增设了事后审计,即使“门禁”没能拦截某些操作,事后快照比对仍能发现异常。
设计四:原子写与断点续跑——崩溃后可从最近落盘点恢复
长程任务运行过程中,进程崩溃、网络中断等异常不可避免。Sonic 为此设计了原子写与断点续跑机制。
所有状态写入都遵循“先写临时文件,写完再原子替换”的原则。保证任何时刻读取状态文件,要么得到完整的旧版本,要么得到完整的新版本,不会出现写入不完整的中间状态。
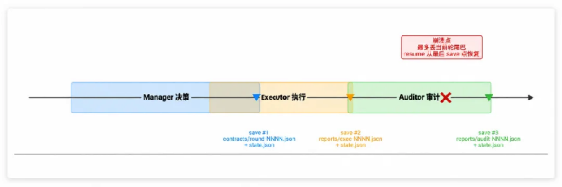
每轮执行中有三个落盘点,Manager 决策后、Executor 报告后,以及Auditor 报告后。即使程序在某一轮中途崩溃,损失也仅限于当前轮次,此前所有轮次的合约、报告、审计记录全部完整保留。
崩溃后的恢复通过resume命令完成,从磁盘反序列化状态文件,使用相同的session_id重建Manager的历史规划记忆。Executor和Auditor因每轮新建会话,无需恢复。恢复后轮次编号继续递增,任务从最后一个落盘点继续执行。
04 数据验证:移除关键设计后的性能变化
机制设计的有效性还需要通过ablation(消融实验)进行验证,移除某项机制后观察性能下降幅度,才能证明该机制确实发挥了作用。
技术报告中给出了Sonic Harness在 VulnHouse 两个真实红队任务集(约 30 道题)上运行的对照数据,结果如下:
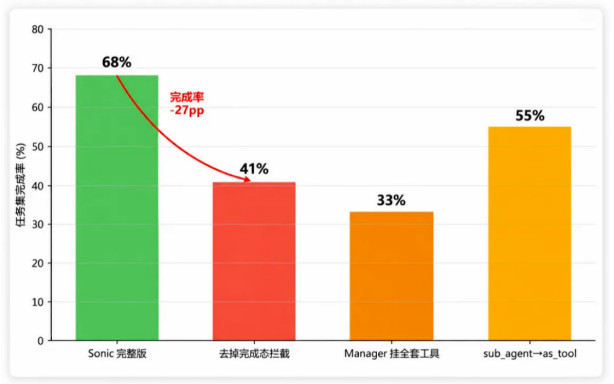
通过对比可以看到,移除完成态拦截后出现明显的性能下降:完成率从 68% 降至 41%。原因在于,失去外部审计校验后,Manager 会在自身推理链中不断确认自己声称的完成状态,幻觉自证效应会持续累积。
另一组显著的变化是,让Manager 也直接挂载和Executor相同的全套工具,相当于还原成普通单Agent 模式,任务完成率只剩 33%,而且平均每个任务出现 2.1 次完整性违规。Manager 在本应仅做决策的位置直接执行文件写入和命令操作,破坏了后续审计的基础。
消融实验的数据比较结果说明:MEA三角色物理隔离与完成态铁律并非附加优化,而是长程任务能够稳定运行的必要条件。
05 写在最后:Agent 长程竞争,进入“执行框架时代”
回过头来看,Sonic Harness 的四道设计形成了一个相互咬合的完整机制:
- 1. 角色物理隔离,Manager/Executor/Auditor 三方工具集、上下文、会话 ID 完全分离;
- 2. 审计独立于执行,Auditor 每轮新建会话,仅挂载只读工具,不采信 Executor 的自然语言叙述;
- 3. 每轮抛弃与跨轮复用并存,Manager 跨轮复用以保留规划记忆,Executor 与 Auditor 每轮抛弃以保持客观性;
- 4. 无人介入是唯一出路,Manager 决策动作不包含 “求助” 选项,遇阻仅能通过 blocked 上报。
这也揭示了一个行业趋势:当基础模型的能力逐渐趋同,Agent 长程稳定性的竞争,已经从 “谁的模型更聪明” 转向 “谁的执行框架更严谨”。
当然,Sonic Harness依然存在一些局限性,例如:部分端点的思维链输出格式与主流不一致,底层已保留MCP接入面,但CLI与Web入口尚未启用。但这些局限并不影响上述设计原则的有效性。
Sonic Harness是长程安全Agent领域的一个新起点,而非终点。设计理念在渗透测试之外的长程Agent场景中同样具有参考价值,无论任务类型如何,“模型声称完成” 与 “实际完成” 之间,始终需要一道独立验证的关卡。
10月份,Sonic Harness也将正式上架「蛙池 AI Desktop・蛙伴市场」,届时大家可以去蛙池 AI Desktop中体验。